Анализ рынка нейросетями
Как выглядит исследование рынка антиперспирантов, если поручить машине чтение тысяч описаний и отзывов: что она находит, что упускает и как не принять шум за сигнал.
Классическое маркетинговое исследование выглядит так: аналитик неделями читает описания продуктов, выписывает обещания брендов, сводит их в таблицу и пытается понять, где на этой карте пустое место. Работа полезная, но крайне медленная, и объём материала всегда приходится урезать до того, что человек физически успевает прочитать.
Языковые модели снимают именно это ограничение. Они не делают исследование умнее, но делают его шире: вместо ста описаний можно обработать несколько тысяч и увидеть распределение, а не выборку из первых страниц выдачи.
Что именно мы просили модель сделать
Первая задача — нормализация языка. Разные бренды описывают одно и то же по-разному: «защита на 48 часов», «двое суток свежести», «длительный контроль потоотделения». Человеку очевидно, что это одна категория обещания; таблице — нет. Модель приводила формулировки к общему виду, и только после этого их можно было считать.
Вторая задача — разметка претензий. В открытых отзывах люди пишут не про химию, а про быт: пятна на рубашке, жжение после бритья, липкость, слишком резкий аромат, флакон, который заканчивается за три недели. Мы просили модель раскладывать такие высказывания по темам и отдельно помечать, о каком именно моменте использования идёт речь.
Третья задача — поиск противоречий. Интереснее всего не самая частая жалоба, а та, где ожидания расходятся с реальностью. Например, когда покупатель одновременно хочет мощную защиту и полное отсутствие ощущения на коже: это не невозможный запрос, но он задаёт конкретное техническое требование к основе формулы.
- Приведение маркетинговых формулировок к сопоставимым категориям обещаний.
- Разметка потребительских претензий по темам: комфорт, следы на одежде, аромат, расход, ощущение на коже.
- Группировка сценариев использования — офис, тренировка, поездка, ночная смена.
- Выявление противоречивых требований, которые нужно решать формулой, а не текстом на упаковке.
- Оценка того, какие обещания на рынке звучат чаще всего и потому уже не воспринимаются как аргумент.
Где машина ошибается
Первая и самая частая ошибка — уверенное обобщение на слабых данных. Модель охотно выдаёт аккуратный вывод там, где материала было мало, и вывод выглядит убедительно просто потому, что написан ровным языком. Поэтому любую сводку мы просили сопровождать примерами исходных высказываний: если под выводом нет цитат, вывод не считается.
Вторая — смещение выборки. Отзывы пишут не все, а те, у кого был сильный опыт, чаще негативный. Массив открытых текстов систематически перекошен, и относиться к нему как к социологии нельзя. Мы использовали его как источник гипотез, а не как измерение доли рынка.
Третья — путаница между дезодорантом и антиперспирантом. В обычной речи эти слова смешивают постоянно, и часть претензий к «дезодоранту, который не спасает от пота» относится к средству, которое от пота и не должно спасать. Такие случаи приходилось отделять вручную.
Что из этого получилось
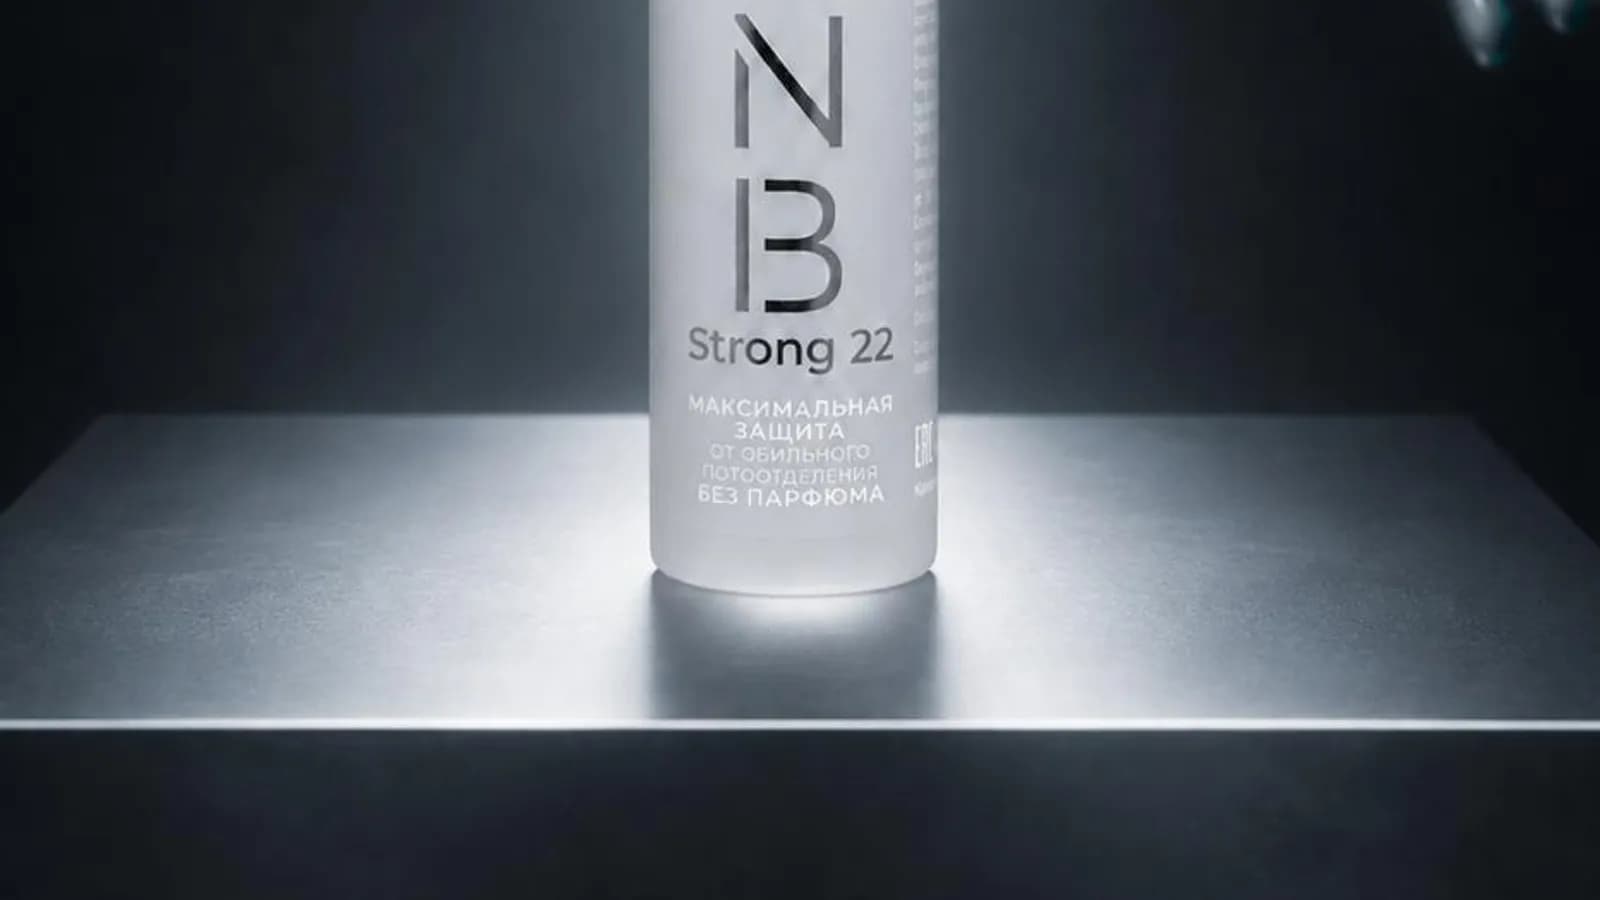
Из анализа выросли вполне приземлённые решения. Стало понятно, что одной концентрации мало: часть людей ищет максимальную защиту, часть — мягкость и повседневность. Так линейка разделилась на Strong 17% и Strong 22%. Стало понятно и то, насколько часто спирт в составе связывают с дискомфортом после бритья — отсюда версия LifeStyle For Her без спирта.
Ещё один вывод касался языка. Обещания вроде «абсолютной сухости» повторяются у стольких брендов, что перестали что-либо значить. Полезнее оказалось объяснять механику: почему нанесение на ночь работает лучше, чем утреннее, и от чего зависит длительность защиты.
Как устроена проверка вывода
Чтобы машинный анализ не превратился в генератор правдоподобных утверждений, мы использовали простую процедуру. Любая сводка сопровождается выборкой исходных высказываний, на которых она построена, и человек читает эту выборку целиком. Если после чтения вывод перестаёт казаться очевидным, он отправляется на переформулировку, а не в бриф.
Второй приём — разделение источников. Описания продуктов, тексты регуляторов и потребительские отзывы разбираются отдельно и не смешиваются в один массив. Это звучит очевидно, но именно смешение источников чаще всего порождает красивые и бессмысленные обобщения: маркетинговое обещание и реальный опыт человека имеют разный вес, а модель по умолчанию относится к ним одинаково.
Третий — повторный прогон с другой постановкой вопроса. Если сформулировать запрос иначе и получить противоположную картину, значит, данных недостаточно для устойчивого вывода. Такая проверка отсеивает изрядную долю первоначальных «находок», зато то, что остаётся, обычно выдерживает столкновение с реальностью.
Нейросети здесь сыграли роль хорошего ассистента-читателя: они не приняли ни одного решения, но позволили увидеть картину целиком и потратить человеческое время на то, что действительно требует суждения.
- #анализ рынка
- #данные
- #нейросети
- #исследование